Vamos a programar #57 - Los números de Munchhausen (ver. Java android)
Hola de nuevo a todos, el día de hoy vamos a ver cómo probar los números de Munchhausen en java para usarse en dispositivos con android.

El código ha cambiado un poco, en el caso de la función "IsMunchhuasenNumber()", todo se mantiene igual, es decir; se prueba un número y si este cumple la conjetura, la funcion devuelve "true", en caso contrario se devuelve "false".
La función "TestNumbers", es la que sufrido varios cambios. Para empezar, los parámetros que está recibe, los primeros dos se mantienen del tipo "int", pero el tercer parámetro pasa a ser del tipo "boolean" al tipo "int", esto solo hace por practicidad, un poquito más adelante veremos el por qué. Otro de los cambios que sufre, es que ahora pasa a ser una función en vez de un procedimiento. El valor que regresa es un valor del tipo "ArrayList", que es la lista en la cual se van almacenado los valores de salida. Cada vez que se prueba la conjetura para un número, se regresa una cadena de texto similar a "el número n no/cumple la conjetura", en la versión de C#, directamente se usaba el delegado y la función "UpdateList()" para hacerlo pero en este y debido a cómo está estructurado, pensé que era mejor hacerlo así.
A diferencia de los muchos otros códigos que he dicho que voy a "optimizar" (y que no he hecho), este ahora si usa un "Thread" diferente para hacer los cálculos y que no se bloquee la interfaz principal, para eso hacemos uso de la Subclase "UpdateList" que hereda de la clase "AsyncTask" (no se si sea en valido decir "hereda" en java, pero creo que si o si no se entiende). En el post de la semana que viene, veremos cómo usar esta clase para poder brindar un poco de "Multithreading", pero por ahora, al crear la instancia, pasamos tres parámetros que son "<Integer, Void, ArrayList>". Para poder usar la clase "AsyncTask", debemos de sobrecargar algunos de los metodos que la componen, en este caso solo son tres (pero hay más) y son: "onPreExecute()", "doInBackground()" y "onPostExecute()". Respectivamente cada uno hace lo siguiente: Es lo que se ejecutará antes de empezar, la parte principal y que mas tiempo va a consumir y la parte donde se procesaran los resultados.
Con el código anterior podemos probar los números de Munchhausen en un dispositivo con android, en el siguiente post veremos cómo es que funciona la clase "AsyncTask" y cómo nos podra ayudar con tareas en segundo plano. El código cómo de costumbre lo pongo en mi dropbox para que lo descargues, recuerda que a partir de este post, solo ira el código del layout principal y el código java. El APK ya compilado lo puedes descargar de mi dropbox directamente o puedes visitar la seccion de descargas del blog.
Y bien, por ahora es todo, los leo luego.

El código.
Cómo ya vimos cuales son las reglas de los números de Munchhausen en el primer post, ahora pasaremos directamente al código en java para poder usarlo. El código es el siguiente:
package com.mdev.munchhausen;

import android.app.Activity;
import android.app.ProgressDialog;
import android.os.AsyncTask;
import android.os.Bundle;
import android.view.View;
import android.widget.ArrayAdapter;
import android.widget.Button;
import android.widget.CheckBox;
import android.widget.ListView;
import android.widget.TextView;

import java.util.ArrayList;

public class MainActivity extends Activity {

	Button BtnDowork;
	TextView TXTMin, TxtMax;
	CheckBox CHKShowAll;
	ListView ShowResults;
	private ProgressDialog progress;

	private boolean IsMunchhausenNumber(String Number)
	{
		int Value = 0;
		int CurrentNumber = 0;
		char[] Digits = Number.toCharArray();
		for (int i = 0; i < Digits.length; i++)
		{
			CurrentNumber = Digits[i] - 48;
			Value += (int)Math.pow(CurrentNumber,CurrentNumber);
		}
		String CurrentVal = String.valueOf(Value);
		if (Number.compareTo(CurrentVal) == 0)
			return true;
		else
			return false;
	}

	private ArrayList TestNumbers(int BeginNumber, int EndNumber, int ShowAll)
	{
		ArrayList TempList = new ArrayList();
		for (int i = BeginNumber; i <= EndNumber; i++)
		{
			if (IsMunchhausenNumber(String.valueOf(i)))
				TempList.add( "La conjetura se cumple para el número " + i);
			else if (ShowAll == 1)
				TempList.add( "El número " + i + " no cumple la conjetura");;
		}
		return TempList;
	}
	@Override
	protected void onCreate(Bundle savedInstanceState) {
		super.onCreate(savedInstanceState);
		setContentView(R.layout.activity_main);
		BtnDowork = (Button)findViewById(R.id.BtnDoWork);
		TXTMin = (TextView)findViewById(R.id.TXTInMin);
		TxtMax = (TextView)findViewById(R.id.TXTInMax);
		CHKShowAll = (CheckBox)findViewById(R.id.CHKShowAll);
		ShowResults = (ListView) findViewById(R.id.LVResults);
		BtnDowork.setOnClickListener(new View.OnClickListener() {
										 @Override
										 public void onClick(View v) {
											 Integer ShowAll = 0;
											 Integer Min = Integer.valueOf(TXTMin.getText().toString());
											 Integer Max = Integer.valueOf(TxtMax.getText().toString());
											 if (CHKShowAll.isChecked())
												 ShowAll = 1;
											 else
												 ShowAll = 0;
												new UpdateList().execute(Min,Max,ShowAll);
										 }
									 }

		);
	}

	private  class UpdateList extends AsyncTask<Integer,Void,ArrayList>
	{
		@Override
		protected void onPreExecute()
		{
			progress = ProgressDialog.show(MainActivity.this, "Espera...", "Espera...!!!");
		}
		@Override
		protected ArrayList doInBackground(Integer... Limits)
		{
			ArrayList Lista = new ArrayList();
			Lista = TestNumbers(Limits[0],Limits[1],Limits[2]);
			return Lista;
		}
		@Override
		protected void onPostExecute(ArrayList result)
		{
			super.onPostExecute(result);
			final ArrayAdapter adapter = new ArrayAdapter(MainActivity.this,android.R.layout.simple_list_item_1, result);
			ShowResults.setAdapter(adapter);
			progress.dismiss();
		}
	}
}
El código ha cambiado un poco, en el caso de la función "IsMunchhuasenNumber()", todo se mantiene igual, es decir; se prueba un número y si este cumple la conjetura, la funcion devuelve "true", en caso contrario se devuelve "false".
La función "TestNumbers", es la que sufrido varios cambios. Para empezar, los parámetros que está recibe, los primeros dos se mantienen del tipo "int", pero el tercer parámetro pasa a ser del tipo "boolean" al tipo "int", esto solo hace por practicidad, un poquito más adelante veremos el por qué. Otro de los cambios que sufre, es que ahora pasa a ser una función en vez de un procedimiento. El valor que regresa es un valor del tipo "ArrayList", que es la lista en la cual se van almacenado los valores de salida. Cada vez que se prueba la conjetura para un número, se regresa una cadena de texto similar a "el número n no/cumple la conjetura", en la versión de C#, directamente se usaba el delegado y la función "UpdateList()" para hacerlo pero en este y debido a cómo está estructurado, pensé que era mejor hacerlo así.
A diferencia de los muchos otros códigos que he dicho que voy a "optimizar" (y que no he hecho), este ahora si usa un "Thread" diferente para hacer los cálculos y que no se bloquee la interfaz principal, para eso hacemos uso de la Subclase "UpdateList" que hereda de la clase "AsyncTask" (no se si sea en valido decir "hereda" en java, pero creo que si o si no se entiende). En el post de la semana que viene, veremos cómo usar esta clase para poder brindar un poco de "Multithreading", pero por ahora, al crear la instancia, pasamos tres parámetros que son "<Integer, Void, ArrayList>". Para poder usar la clase "AsyncTask", debemos de sobrecargar algunos de los metodos que la componen, en este caso solo son tres (pero hay más) y son: "onPreExecute()", "doInBackground()" y "onPostExecute()". Respectivamente cada uno hace lo siguiente: Es lo que se ejecutará antes de empezar, la parte principal y que mas tiempo va a consumir y la parte donde se procesaran los resultados.
Con el código anterior podemos probar los números de Munchhausen en un dispositivo con android, en el siguiente post veremos cómo es que funciona la clase "AsyncTask" y cómo nos podra ayudar con tareas en segundo plano. El código cómo de costumbre lo pongo en mi dropbox para que lo descargues, recuerda que a partir de este post, solo ira el código del layout principal y el código java. El APK ya compilado lo puedes descargar de mi dropbox directamente o puedes visitar la seccion de descargas del blog.
Y bien, por ahora es todo, los leo luego.
android
,
AsyncTask
,
java
,
munchhausen
,
programacion
Vamos a programar #56 - Los números de Munchhausen (ver. Javascript)
Hola de nuevo a todos, el día de hoy vamos a continuar con la prueba de la conjetura de los números de Munchhausen.

En el post anterior vimos cuales son las reglas, por lo que ahora pasaremos directamente al código javscript para ver las diferencias entre la versión de C# y esta.
El código anterior solo consta de tres funcione en esta ocasión en la función "NumberToDigits()" al convertir el número de entrada a los dígitos que lo forman, directamente hace la resta de 48 para poder usar el número directamente. Para poder recuperar los valores de cada control, hacemos uso de la función "document.getElementById".

Cómo de costumbre, el código lo dejo en mi dropbox para que lo pruebes, al ser el mismo "concepto" que la versión de C#, no requiere una explicación mayor. La semana que viene, veremos la versión para android.
Los leo luego.

En el post anterior vimos cuales son las reglas, por lo que ahora pasaremos directamente al código javscript para ver las diferencias entre la versión de C# y esta.
El código.
El código en javascript para probar los números de Munchhausen es el siguiente:
<html>
	<head>
		<style type="text/css">
		.h1M
		{
			font-size: 16px;
		}
		.formVigenere{
			font: 95% Arial, Helvetica, sans-serif;
			max-width: 400px;
			margin: 10px auto;
			padding: 16px;
			background: #F9F9F9;
		}
		.textareaM
		{
			width: 100%;
			height: 150px;
			padding: 2px 5px;
			box-sizing: border-box;
			border: 2px solid #999;
			border-radius: 4px;
			resize: none;
			-webkit-transition-duration: 0.4s; /* Safari */
			transition-duration: 0.4s;
		}

		.textareaM:focus
		{
			width: 100%;
			height: 150px;
			padding: 2px 5px;
			box-sizing: border-box;
			border: 2px solid #00BB00;
			border-radius: 4px;
			resize: none;
		}

		.TextM
		{
			width: 100%;
			box-sizing: border-box;
			border: 2px solid #999;
			border-radius: 4px;
		}

		.ButtonM
		{
		width: 100%;
			background-color: #009900;
			border: none;
			color: white;
			padding: 15px 32px;
			text-align: center;
			text-decoration: none;
			display: inline-block;
			-webkit-transition-duration: 0.4s; /* Safari */
			transition-duration: 0.4s;
		}

		.ButtonM:hover
		{
		width: 100%;
			background-color: #4CAF50;
			border: none;
			color: white;
			padding: 15px 32px;
			text-align: center;
			text-decoration: none;
			display: inline-block;
		}
		</style>
		<script type="text/javascript">
		function NumberToDigits(Number){
			var Out = [];
			for(var i = 0; i < Number.length; i++){
				var CodeChar = Number.charCodeAt(i);
					Out.push(CodeChar - 48);
			}
			return Out;
		}

		function IsMunchhausen(Number){
			var Result = 0;
			var Digits = NumberToDigits(Number);
			for(var i = 0; i < Digits.length; i++){
				Result += Math.pow(Digits[i], Digits[i]);
			}
			if (Number == Result.toString()){
				return true;
			}
			else{
				return false;
			}
		}
		function TestNumbers(){
			document.getElementById('Result').value = "";
			BeginNumber = document.getElementById('MinNumber').value;
			EndNumber = document.getElementById('MaxNumber').value;
			SHowAll = document.getElementById('ShowAll').checked;
			for (var i = BeginNumber; i <= EndNumber; i++){
				if (IsMunchhausen(i.toString()))
					document.getElementById('Result').value += "La conjetura se cumple para el número " + i + "\n";
				else if (SHowAll)
					document.getElementById('Result').value += "El número " + i + " no cumple la conjetura\n";
			}
		}
		 </script>
	</head>
	<body>
	Utilidad para probar la conjetura de Munchhausen usando javascript.
	<form class="formVigenere">
		<span class="h1M">Numero de donde empezar:</span>
		<br />
		<input class="TextM" id="MinNumber" value = "1" type="text"></input><br />
		<span class="h1M">Numero hasta donde llegar</span><br /><br/>
		<input class="TextM" id="MaxNumber" value = "5000" type="text" /><br />
		<br />
		<input class="ButtonM" id="Calcula" onclick="TestNumbers()" type="button" value="Calcular" /><br />
		<br />
		<input type="checkbox" id = "ShowAll" value="Bike">Mostrar Todo<br><br>
		<span class="h1M">Resultado</span><br/>
		<textarea class="textareaM" id="Result" rows="5"></textarea><br/><br/>
	</form>
	</body>
<html>
El código anterior solo consta de tres funcione en esta ocasión en la función "NumberToDigits()" al convertir el número de entrada a los dígitos que lo forman, directamente hace la resta de 48 para poder usar el número directamente. Para poder recuperar los valores de cada control, hacemos uso de la función "document.getElementById".

Cómo de costumbre, el código lo dejo en mi dropbox para que lo pruebes, al ser el mismo "concepto" que la versión de C#, no requiere una explicación mayor. La semana que viene, veremos la versión para android.
Los leo luego.
CSS
,
HTML
,
Javascript
,
munchhausen
,
programacion
Vamos a programar #55 - Los números de Munchhausen (ver. C#)
Hola de nuevo a todos, el día de hoy vamos a ver los números de Munchhausen y cómo probar la conjetura usando código en C#.
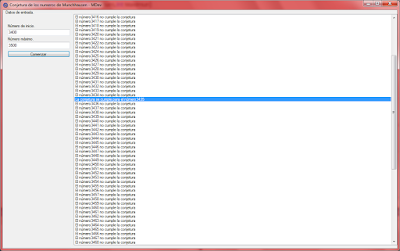
Antes que nada, veamos la definicion de los número de Munchhausen segun wikipedia:
El código anterior consta de cuatro funciones, pero solo la función "IsMunchhausenNumber()" es la que hace el trabajo, el resto solo son para poder usar la aplicación y que esta no se bloquee cuando se realice el proceso.
La función "IsMunchhausenNumber" recibe un parámetro del tipo "string" que será la cadena de texto que representa el número que se va a probar; decidí tomar directamente el parámetro cómo un "string" debido a que cuando recuperamos el número de la caja de texto, este sera de ese tipo, entonces convertirlo y luego hacer una conversión más para poder separarlo en los dígitos, significa doble trabajo.
Dentro de la función, convertimos el parámetro ingresado en un "array" del tipo "char", cada elemento representara un dígito del número ingresado. Luego para poder hacer los cálculos con cada dígito, a cada valor del tipo "char" le restamos 48 para obtener su valor real. Hay que recordar que el tipo "char" es esencialmente igual al tipo "byte" por lo que podemos restar (aunque habría que hacer la conversión implícita pero meh). La razón por la que se resta 48, es porque el número cero, esta en el lugar 48, el uno es 49 y así sucesivamente hasta el número nueve. Si intentamos convertir el valor del tipo "char" "0" a uno del tipo "int", este regresará 48, por lo que hacer la resta directamente resulta más fácil.
Después con los numero ya separados se hace la suma siguiendo las reglas de la conjetura y se compara el valor de la variable usada para hacer la suma con el número ingresado cómo parámetro; si estos son iguales entonces la función devuelve un valor del tipo "bool" "true", en caso contrario devuelve "false".
Para probar los número, se hace uso de la función "TestNumbers". Esta función recibe tres parámetros, el primero del tipo "int" que servirá cómo limite mínimo para empezar a probar los números. El segundo parámetro también del tipo "int" sirve para marcar el limite máximo hasta cual se van a probar los números, finalmente el tercer parámetro del tipo "bool", servirá par filtrar los resultados; solo cuando este sea "true", todos los resultados sin importar que cumplan la conjetura, se agregan a la lista de salida, en caso contrario, solo los que la cumplen son agregados.

Y bien, por ahora es todo en futuros post veremos que hacen el resto de las funciones (que de seguro habrás notado que aparecen en varios de los programas del blog) y probablemente al igual que algunos otros de los programas, crearemos versiones para android en java y web en javascript. Cómo de costumbre, puedes descargar el código fuente de mi dropbox para que lo pruebes.
Los leo luego

Antes que nada, veamos la definicion de los número de Munchhausen segun wikipedia:
El término fue acuñado por el ingeniero de software y matemático holandés Daan van Berkel en 2009. El nombre se debe a que cada dígito está "elevado" por sí mismo, esto evoca la historia de Barón Munchausen que se elevó a sí mismo hacia arriba jalando su propia coleta. Los números narcisistas siguen una regla similar, pero en el caso de los números narcisistas la potencia de los dígitos es fija, siendo elevados a la potencia del número de dígitos en el número.En resumidas cuentas, se trata de tomar un número y separar cada dígito y este a su vez elevarlo a la potencia que será el mismo dígito. Antes de continuar, actualmente solo hay dos números conocidos que cumplen la conjetura. uno de ellos es el número 1 puesto que:
- 1 = 1^1 = 1.
- 3435 = 3^3 + 4^4 + 3^3 + 5^5 = 27 + 256 + 27 + 3125 = 3435.
El código.
El código en C# que sirve para probar la conjetura es el siguiente:
using System;
using System.Collections.Generic;
using System.ComponentModel;
using System.Data;
using System.Drawing;
using System.Linq;
using System.Text;
using System.Windows.Forms;
using System.Threading;

namespace Munchhausen
{
	public partial class FrmMain : Form
	{
		private bool IsBusy = false;
		private delegate void UpdateListDelegate(string Value);
		private void UpdateList(string Value)
		{
			if (LBResults.InvokeRequired)
				LBResults.Invoke(new UpdateListDelegate(UpdateList), Value);
			else
				LBResults.Items.Add(Value);
		}
		private bool IsMunchhausenNumber(string Number)
		{
			int Value = 0;
			int CurrentNumber = 0;
			char[] Digits = Number.ToCharArray();
			for (int i = 0; i < Digits.Length; i++)
			{
				CurrentNumber = Digits[i] - 48;
				Value += (int)Math.Pow(CurrentNumber,CurrentNumber);
			}
			if (Number == Value.ToString())
				return true;
			else
				return false;
		}
		private void TestNumbers(int BeginNumber, int EndNumber, bool SHowAll)
		{
			for (int i = BeginNumber; i <= EndNumber; i++)
			{
				if (IsMunchhausenNumber(i.ToString()))
					UpdateList("La conjetura se cumple para el número " + i);
				if (SHowAll)
					UpdateList("El número " + i + " no cumple la conjetura");
			}
			IsBusy = false;
		}
		private void RunWork(int Minimum, int Maximun, bool ShowAll = false)
		{
			Thread DoWork = new Thread(new ThreadStart(() => TestNumbers(Minimum, Maximun,ShowAll)));
			IsBusy = true;
			DoWork.Start();
		}
		public FrmMain()
		{
			InitializeComponent();
		}

		private void BtnStart_Click(object sender, EventArgs e)
		{
			LBResults.Items.Clear();
			if (!IsBusy)
				RunWork(int.Parse(TxtMinNumber.Text), int.Parse(TxtMaxNumber.Text),CHKShowTrue.Checked);
			else
				MessageBox.Show("Hay una operación en proceso, espera","MDev",MessageBoxButtons.OK,MessageBoxIcon.Exclamation);
		}

		private void FrmMain_FormClosing(object sender, FormClosingEventArgs e)
		{
			if (IsBusy == true)
			{
				MessageBox.Show("No se puede salir ahora","MDev", MessageBoxButtons.OK, MessageBoxIcon.Exclamation);
				e.Cancel = true;
			}
		}
	}
}
El código anterior consta de cuatro funciones, pero solo la función "IsMunchhausenNumber()" es la que hace el trabajo, el resto solo son para poder usar la aplicación y que esta no se bloquee cuando se realice el proceso.
La función "IsMunchhausenNumber" recibe un parámetro del tipo "string" que será la cadena de texto que representa el número que se va a probar; decidí tomar directamente el parámetro cómo un "string" debido a que cuando recuperamos el número de la caja de texto, este sera de ese tipo, entonces convertirlo y luego hacer una conversión más para poder separarlo en los dígitos, significa doble trabajo.
Dentro de la función, convertimos el parámetro ingresado en un "array" del tipo "char", cada elemento representara un dígito del número ingresado. Luego para poder hacer los cálculos con cada dígito, a cada valor del tipo "char" le restamos 48 para obtener su valor real. Hay que recordar que el tipo "char" es esencialmente igual al tipo "byte" por lo que podemos restar (aunque habría que hacer la conversión implícita pero meh). La razón por la que se resta 48, es porque el número cero, esta en el lugar 48, el uno es 49 y así sucesivamente hasta el número nueve. Si intentamos convertir el valor del tipo "char" "0" a uno del tipo "int", este regresará 48, por lo que hacer la resta directamente resulta más fácil.
Después con los numero ya separados se hace la suma siguiendo las reglas de la conjetura y se compara el valor de la variable usada para hacer la suma con el número ingresado cómo parámetro; si estos son iguales entonces la función devuelve un valor del tipo "bool" "true", en caso contrario devuelve "false".
Para probar los número, se hace uso de la función "TestNumbers". Esta función recibe tres parámetros, el primero del tipo "int" que servirá cómo limite mínimo para empezar a probar los números. El segundo parámetro también del tipo "int" sirve para marcar el limite máximo hasta cual se van a probar los números, finalmente el tercer parámetro del tipo "bool", servirá par filtrar los resultados; solo cuando este sea "true", todos los resultados sin importar que cumplan la conjetura, se agregan a la lista de salida, en caso contrario, solo los que la cumplen son agregados.

Y bien, por ahora es todo en futuros post veremos que hacen el resto de las funciones (que de seguro habrás notado que aparecen en varios de los programas del blog) y probablemente al igual que algunos otros de los programas, crearemos versiones para android en java y web en javascript. Cómo de costumbre, puedes descargar el código fuente de mi dropbox para que lo pruebes.
Los leo luego
Vamos a platicar #7 - Luchando contra la estupidez (última vez).
Hola de nuevo a todos. En el post del día de hoy vamos a retomar un poco del trabajo de UNAM.
Parece que últimamente, cada vez que escribo una sección de "Vamos a platicar", es sinónimo de "vamos a joder a alguien porque cree que los sismos son producto del HARP (sea lo que sea)" y no por las placas tectónicas; es decir; de forma natural.

Hace algunos días, de nueva cuenta se activó la alerta sísmica en la zona metropolitana de la Ciudad de México. Por fortuna el movimiento fue muy leve (por no decir imperceptible). Si has leido algunos post viejos de esta misma serie, sabrás que siempre trato de usar cómo referente la información proporcionada por el SSN.
Para no9 hacerle al feo a la costumbre, de inmediato salio gente que aseguraba que la magnitud estaba mal, "nos mienten", "se sintio pior" y cosas por el estilo. Cómo de costumbre hice lo minimo por tratar de persuadir a estas personas de que el SSN dice la verdad. Uno de ellos pregunto "¿y cómo sabes que no mete la mano el gobierno?". Yo sabía que la informacion practimente se publica en bruto (por eso despues los ajustes), pero realmente cómo es que se crea y se publica la información.
La solución, la UNAM creo un boletin en el cual lo explican.
Y bien por ahora es todo. La semana que viene continuaremos con más programación. Por último y por mas repetitivo que suene, no hay que descalificar al las fuentes de información oficiales. Muchas veces lo que sentimos no será lo que se mide, si no lo que pasa.
Los leo luego.
Parece que últimamente, cada vez que escribo una sección de "Vamos a platicar", es sinónimo de "vamos a joder a alguien porque cree que los sismos son producto del HARP (sea lo que sea)" y no por las placas tectónicas; es decir; de forma natural.

Hace algunos días, de nueva cuenta se activó la alerta sísmica en la zona metropolitana de la Ciudad de México. Por fortuna el movimiento fue muy leve (por no decir imperceptible). Si has leido algunos post viejos de esta misma serie, sabrás que siempre trato de usar cómo referente la información proporcionada por el SSN.
Preliminar: SISMO Magnitud 5.9 Loc 9 km al NOROESTE de H HUAJUAPAN DE LEON, OAX 19/07/18 08:31:56 Lat 17.87 Lon -97.83 Pf 55 km pic.twitter.com/XHR6JQUEg3— Sismologico Nacional (@SismologicoMX) 19 de julio de 2018
Para no9 hacerle al feo a la costumbre, de inmediato salio gente que aseguraba que la magnitud estaba mal, "nos mienten", "se sintio pior" y cosas por el estilo. Cómo de costumbre hice lo minimo por tratar de persuadir a estas personas de que el SSN dice la verdad. Uno de ellos pregunto "¿y cómo sabes que no mete la mano el gobierno?". Yo sabía que la informacion practimente se publica en bruto (por eso despues los ajustes), pero realmente cómo es que se crea y se publica la información.
La solución, la UNAM creo un boletin en el cual lo explican.
El boletín anterior es una copia del original publicado por la UNAM.Boletín UNAM-DGCS-440Ciudad Universitaria.11:00 hs. 21 de julio de 2018GENERAN EN LA UNAM MAPAS DE INTENSIDADES SÍSMICAS Y DAÑOS EN TIEMPO REAL• Pueden contribuir a mejorar la toma de decisiones, dirigir la ayuda más rápido y con mayor eficiencia, e informar con prontitud a la población, explicó Mario Ordaz Schroeder, del Instituto de Ingeniería• Para los mapas se utiliza información que proporcionan instituciones como el Servicio Sismológico Nacional de la UNAM• Un movimiento telúrico tiene una sola magnitud, pero produce muchas intensidades, que son una medida instrumental y objetiva relacionada con los daños estructurales, aclaróEn los primeros minutos después de un sismo se produce un vacío de información en el que las autoridades no saben con precisión cuáles son los sitios más afectados o si se han producido daños en las estructuras de las edificaciones.Por ello, la Coordinación de Ingeniería Sismológica del Instituto de Ingeniería de la UNAM genera mapas de intensidades y daños del territorio nacional en tiempo real, que pueden contribuir a mejorar la toma de decisiones, dirigir la ayuda más rápido y con mayor eficiencia, e informar con prontitud a la población si estamos o no ante una calamidad.Mario Ordaz Schroeder explicó que un movimiento telúrico tiene una sola magnitud; por ejemplo, la del sismo del 19 de septiembre pasado fue de 7.1, pero las intensidades que se produjeron respecto al mismo fueron muchas.“La intensidad sísmica es una medida local de la severidad del movimiento del suelo; está relacionada con la magnitud del temblor, pero depende de otros factores como la distancia desde el epicentro, el tipo de suelo o la ruptura de las placas tectónicas”.A las construcciones no les “importa” si el temblor fue de magnitud 7 u 8, lo que las puede afectar es cuánto se acelera el suelo en su base. “Cuando tiembla, el suelo se mueve y esas aceleraciones se convierten en fuerzas de inercia sobre las estructuras”; por ello, la intensidad es una medida instrumental y objetiva relacionada con los daños estructurales, detalló el experto.De ahí la importancia de crear mapas de intensidad sísmica muy poco tiempo después de que ocurrió un sismo. “Eso implica que existe la posibilidad de registrar la aceleración en el suelo, mediante instrumentos denominados acelerómetros, y llevar esos datos a un sitio central de recepción de manera automática, sin intervención humana, mediante infraestructura de comunicaciones; ya con los datos, un programa genera los llamados shake maps y los difunde”.En México, para generar los mapas se utiliza información que proporcionan diferentes instituciones, entre ellas el Servicio Sismológico Nacional, que opera el Instituto de Geofísica.Se cuenta con una cobertura nacional heterogénea, muy buena en Guerrero y Oaxaca, en donde hay una red que opera el Instituto de Ingeniería, y muy mala en regiones como la noroeste.Cuando se presenta un temblor, expuso Mario Ordaz, se “dispara” automáticamente el proceso que toma los registros. El sistema identifica si se trata de un temblor o no, y de acuerdo con los valores de aceleración, determina hacer público un mapa.En ellos se utiliza un código de color muy sencillo: rojo es “malo” y verde es “bueno”. En el sismo del 7 de septiembre se creó una imagen que el especialista calificó como “escalofriante”. Se observa un área de rojo intenso sobre Oaxaca y Chiapas, pero con tonos rojizos que llegaron hasta Veracruz y Puebla.Para la Ciudad de México, que cuenta con una red de acelerómetros densa, de más de 100 instrumentos, se crean “mapas muy razonables de la intensidad”; así ocurrió con el sismo del 19 de septiembre y otros, finalizó Mario Ordaz.
Y bien por ahora es todo. La semana que viene continuaremos con más programación. Por último y por mas repetitivo que suene, no hay que descalificar al las fuentes de información oficiales. Muchas veces lo que sentimos no será lo que se mide, si no lo que pasa.
Los leo luego.
Learning Machine #11 - Programando en Pascal - Ciclos for y repeat.
Hola de nuevo a todos, el dia de hoy vamos a continuar con la serie "learning machine" para el lenguaje de programación Pascal. Anteriormente vimos algunas de las partes mas importanes del lenguaje, pero por alguna razon las parte número 9 no la publique o no lo hice bien. El punto es que vamos a ver una parte importante. Cómo usar los ciclos.

Muchas veces debemos hacer operaciones que requieren ser repetidas N número de veces, anteriormente vimos que podemos hacer que algumos procesos se repitan haciendo uso de while, pero que pasa si lo que queremos hacer, ya lo tenemos bien definido, bien, para eso existe el ciclo for.
Para hacer uso del ciclo, debemos de hacer uso de la palabra reservada "for" seguida del número desde cual se va empezar a contar, se debe de usar una variable que es la que usaremos a manera de contador. Seguido viene la palabra reservada "to" y despues viene lo que será el "tope" del ciclo, una vez indicado esto viene la palabra reservada "do" y dependiendo de cuanto código vamos a usar, podemos hacer uso de "begin" (para inidicar el inicio), todo el código contenido entre éste y su respectivo "end;", será lo que se ejecutará hasta que el contador llegue al limite indicado.
Ahora imaginemos que queremos hacer un programa que cuente del 1 al 100 y que además escriba "este mensaje se ha escrito N veces" en la consola. tomando en cuenta lo anterior, podemos hacer código cómo el siguiente:


Muchas veces debemos hacer operaciones que requieren ser repetidas N número de veces, anteriormente vimos que podemos hacer que algumos procesos se repitan haciendo uso de while, pero que pasa si lo que queremos hacer, ya lo tenemos bien definido, bien, para eso existe el ciclo for.
Ciclo for.
El ciclo for sirve para hacer N veces determinada tarea, en pascal la forma más básica de si uso es la siguiente:
{ ... }
{ ... }
	for {Desde} to {hasta} do
	begin
		{ haz algo }
	end;
{...}
{...}
Para hacer uso del ciclo, debemos de hacer uso de la palabra reservada "for" seguida del número desde cual se va empezar a contar, se debe de usar una variable que es la que usaremos a manera de contador. Seguido viene la palabra reservada "to" y despues viene lo que será el "tope" del ciclo, una vez indicado esto viene la palabra reservada "do" y dependiendo de cuanto código vamos a usar, podemos hacer uso de "begin" (para inidicar el inicio), todo el código contenido entre éste y su respectivo "end;", será lo que se ejecutará hasta que el contador llegue al limite indicado.
Ahora imaginemos que queremos hacer un programa que cuente del 1 al 100 y que además escriba "este mensaje se ha escrito N veces" en la consola. tomando en cuenta lo anterior, podemos hacer código cómo el siguiente:
Program Ciclofor;
uses crt, sysutils;
var
Contador : integer;
begin
	for Contador := 1 to 100 do
	begin
		writeln(concat('Este mensaje se ha escrito ', IntToStr(Contador) ,' veces usando for'));
	end;
	readln();
end.
Repeat until.
El bucle Repeat until, es muy similar al bucle while, es decir el ciclo se repetirá hasta que cierta condicion se cumpla.
Para hacerlo, primero debemos de hacer uso de la palabra reservada "repeat", luego escribiremos todo el código que se va a ejecutar y finalmente, pondremos la palabra reservada "until" y la condición que se debe de cumplir.
En la forma más simple, el bucle repeat tendrá la siguiente forma:
{ ... }
{ ... }
	repeat
		{ haz algo }
		{ haz algo }
		{ haz algo }
		{ haz algo }
	until ({condicion});
{...}
{...}
Para tener una mejor idea de cómo se usa, vamos a hacer el mismo programa que usamos cómo ejemplo en el ciclo "for" solo que ahora lo adaptaremos a "repeat".
Program RepeatUntil;
uses crt, sysutils;
var
Contador : integer;
begin
	Contador := 100;
	repeat
		writeln(concat('Este mensaje se ha escrito ', IntToStr(Contador) ,' veces usando until'));
		Contador := Contador + 1;
	until (Contador > 100);
	readln();
end.

Algo importante que hay que resaltar, es que "repeat" a diferencia de "while", ejecutará al menos una vez el código dentro del bloque, esto debido a que la expresion se evalua hasta el final, cosa contraria a "while". Si quieres probar esto, puedes asignarle el valor de 100 a la variable "Contador" justo antes de "Repeat", la condicion ya se cumple, porque por obvio que parezca, 100 es mayor que 99.
Y bien, por ahora es todo, en post futuros veremos más aprendizaje de pascal (incluso la primer imagen te puede dar una idea de lo que viene). Puedes copiar los códigos anteriores para probarlos.
Los leo luego.
Vamos a programar #54 - ID3 y LUA.
Hola de nuevo a todos, el día de hoy vamos a ver código en LUA que sirve para extraer las imágenes embebidas en un MP3. No es lo lo más optimizado, pero a veces lo que cuenta es conseguir nuestro objetivo.

Antes de continuar, es recomendable que leas uno de los post antiguos del blog en cual se explica cómo hacer de manera "artesanal" todo el procedimiento, a veces ayuda un poco saber exactamente que es lo que vamos a hacer para comprender.
Para poder probar el código vamos a necesitar un interprete de LUA para windows (o para PC con cualquier sistema operativo). Si usas windows al igual que yo, recomiendo usar ZeroBrane Studio, es gratuito para todos pero el autor muestra links para donaciones (si puedes apoyarlo hazlo, siempre le cae bien una bebida a cualquier programador independiente). ZeroBrane además de contener el interprete de lua, es un IDE que sirve para depurar código. Es muy importante instalar localmente una copia del interprete para poder abrir los archivos desde nuestro disco duro.
Primero que nada, LUA dispone de funciones de lectura y escritura bastante similares a los de C. Para usar un lector, debemos de iniciarlo pasando dos parámetros, uno de ellos es el archivo que queremos leer (o nuestra canción) y el segundo parámetro es el modo en cual se abrirá; en este caso, usamos "rb" que indicará que leeremos el archivo de forma "binaria".
Al igual que en C, disponemos de una función que sirve para desplazarnos en el archivo que tenemos abierto. Antes de continuar, hay que aclarar algo; LUA no es un lenguaje orientado a objetos pero tiene una sintaxis que ayuda a simularlo y para el código anterior es lo mismo "Rdata:seek("set");" que "Rdata = io.seek("set");" y lo mismo para todos los procedimiento provenientes de cualquier "clase" así que una vez que se inicializa una variable del tipo "io", podemos usar el nombre que le dimos seguido de dos puntos para acceder a los sub-métodos. Entonces, usando "seek" sin ningún parámetro adicional a "set", le indicamos que queremos mover el puntero al inicio del archivo (byte cero)
Cuando ya iniciamos todo, leemos los primeros 1024 bytes del archivo y al igual que en C#, vamos a buscar cualquiera de las etiquetas que se usan para indicar una imagen; es decir: "APIC" o "PIC". Algo que probablemente olvide decir en el primer post sobre imágenes en los MP3's es la importancia de buscar primero "APIC" a algunos les resultará obvio cual es la razón pero a otros no. La razón es simple si buscamos PIC (que corresponde a la versión 2), el resultado de la búsqueda sera verdadero si existe "APIC" porque esta contiene toda la cadena de caracteres que buscamos, en cambio si buscamos "APIC" primero, si no se encuentra, eso no significa que necesariamente no exista "PIC".
Para realizar la búsqueda de la etiqueta, una vez que leímos todos los bytes en los cuales podría estar, creamos un flag llamado "GotIt" del tipo "boolean" y a esta le asignamos el resultado de la función "string.find()" usando cómo parámetros "Sdata" que es una copia de "Rdata" (los 1024 bytes leídos) y es en donde buscará la cadena de texto que le pasamos en el segundo parámetro.
Repetimos lo anterior 4 veces, la primera es para buscar "APIC", la segunda para buscar "PIC" luego si la variable "GotIt" resulta "true" en cualquiera de las dos funciones, hacemos una nueva búsqueda pero ahora en lugar de las etiquetas de imagen, buscamos el tipo de imagen; ya sea PNG o JPG, pero para hacerlo, hacemos uso de de los caracteres que sirven de "encabezado" para los archivos PNG, cómo ya estamos dentro de la condición en la cual si se encontró una etiqueta de imagen, solo hacemos una comprobación y si no encontramos al "encabezado" del archivo PNG entonces la imagen es JPG
Para calcular el tamaño de las imágenes, hay que recordar que seguido de la etiqueta, los cuatro bytes siguientes para la versión tres y los tres bytes siguiente en la versión dos, indican cual es el tamaño de total de la etiqueta, para poder saber cual es el valor, bastará con multiplicar cada byte por potencias de 256, empezando de izquierda a derecha por 256^3 para la versión 3 y 256^2 para la versión dos.
Finalmente guardamos la imagen haciendo uso de un escritor de archivos que se usa igual al de C, es decir creamos el archivo e indicamos cual es el modo en el cual se trabajara, cuando usamos "wb" indicamos que abriremos un archivo pra escribir de forma binaria, si el archivo no existe, se creara uno nuevo.
Para poder usar la función, en ZeroBrane presionaremos F6 y en la parte inferior, el programa no preguntará por la ubicación de una canción seguido de la ubicación que usaremos para guardar la imagen, para este ultimo es importante solo indicar la ruta y el nombre del archivo sin extensión, dentro del programa al determinar si la imagen es jpg o png automáticamente agrega la extensión adecuada.

Y bien por ahora es todo, el código lo puedes copiar y pegar para probarlo.
Los leo luego.

Antes de continuar, es recomendable que leas uno de los post antiguos del blog en cual se explica cómo hacer de manera "artesanal" todo el procedimiento, a veces ayuda un poco saber exactamente que es lo que vamos a hacer para comprender.
Para poder probar el código vamos a necesitar un interprete de LUA para windows (o para PC con cualquier sistema operativo). Si usas windows al igual que yo, recomiendo usar ZeroBrane Studio, es gratuito para todos pero el autor muestra links para donaciones (si puedes apoyarlo hazlo, siempre le cae bien una bebida a cualquier programador independiente). ZeroBrane además de contener el interprete de lua, es un IDE que sirve para depurar código. Es muy importante instalar localmente una copia del interprete para poder abrir los archivos desde nuestro disco duro.
El código.
Con el interprete ya instalado veamos el código.
-----------De la documentación disponible en http://www.id3.org para la versión 2---------------
--[[
Para la version 2.2
	Header for 'Attached picture', ID: "APIC">
	Text encoding   $xx
	MIME type       <text string> $00
	Picture type    $xx
	Description     <text string according to encoding> $00 (00)
	Picture data    <binary data>
Para la version 2.0
	Attached picture   "PIC"
	Frame size         $xx xx xx
	Text encoding      $xx
	Image format       $xx xx xx
	Picture type       $xx
	Description        <textstring> $00 (00)
	Picture data       <binary data>
]]
function WriteImage(NombreDeLaCancion,NombreDeLaImagen)
--Abrimos el archivo en modo de lectura binario
	local Rdata = io.open(NombreDeLaCancion,"rb")
--Ponemos el puntero al inicio del archivo
	Rdata:seek("set")
--Ahora leemos los primeros 1024b del archivo, si no encontramos aquí la etiqueta "APIC" o "PIC" asumimos que el archivo no tiene imagen embebida
	local Sdata = Rdata:read(1024)
--En esta variable Guardaremos la ubicación del La etiqueta "APIC"
	local GotIt = string.find(Sdata,"APIC")
--Si GotIt es nil en este punto, buscamos la etiqueta PIC
	if GotIt == nil then
		GotIt = string.find(Sdata,"PIC")
	end
--
--Si la variable GotIt tiene cualquier valor diferente de nil; procedemos a buscar el tipo de imagen que este embebida.
	if GotIt ~= nil then
		local GotPNG =string.find(Sdata,string.char(137)..string.char(80)..string.char(78)..string.char(71))
	--Obtenemos la versión
		local GetVer = string.find(Sdata,"APIC")
--La comprobación es simple ya llegados a este punto; si uno es falso el otro debe de ser verdadero.
--Regresamos el puntero a la posición en donde se encontró la etiqueta APIC y leemos la longitud de la etiqueta
		local b1,b2,b3,b4
		local TagSize
		if GetVer ~= nil then
			Rdata:seek("set",GotIt+3)
			b1=string.byte(Rdata:read(1))*256*256*256
			b2=string.byte(Rdata:read(1))*256*256
			b3=string.byte(Rdata:read(1))*256
			b4=string.byte(Rdata:read(1))
			TagSize = b1+b2+b3+b4+10
		else
			Rdata:seek("set",GotIt+2)
			b1=string.byte(Rdata:read(1))*256*256
			b2=string.byte(Rdata:read(1))*256
			b3=string.byte(Rdata:read(1))
			TagSize = b1+b2+b3+5
		end
--Si los datos dicen que la imagen es JPG
		if GotPNG  == nil then
			local JPicInit = string.find(Sdata,string.char(255)..string.char(216)..string.char(255))
			Rdata:seek("set",JPicInit-1)
			IMGData = Rdata:read(TagSize-(JPicInit-GotIt))
			local MPImg = io.open(NombreDeLaImagen..".jpg","wb")
			MPImg:write(IMGData)
			MPImg:flush()
			MPImg:close()
			MPImg=nil
		else
			local PPicInit = string.find(Sdata,string.char(137).."PNG")
			local TagDMP
			if GetVer then
				TagDMP=8
			else
				TagDMP=6
			end
			Rdata:seek("set",PPicInit-1)
			local IMGData = Rdata:read(TagSize-(PPicInit-GotIt))
			MPImg = io.open(NombreDeLaImagen..".png","wb")
			MPImg:write(IMGData)
			MPImg:flush()
			MPImg:close()
			MPImg=nil
		end
	end
	Rdata:close()
	Rdata = nil
end

print("Inserta la ubicacion de un mp3")
local FILE = io.read();
print("Inserta un nombre de archivo")
local SavePlace = io.read();
WriteImage(FILE, SavePlace);
Primero que nada, LUA dispone de funciones de lectura y escritura bastante similares a los de C. Para usar un lector, debemos de iniciarlo pasando dos parámetros, uno de ellos es el archivo que queremos leer (o nuestra canción) y el segundo parámetro es el modo en cual se abrirá; en este caso, usamos "rb" que indicará que leeremos el archivo de forma "binaria".
Al igual que en C, disponemos de una función que sirve para desplazarnos en el archivo que tenemos abierto. Antes de continuar, hay que aclarar algo; LUA no es un lenguaje orientado a objetos pero tiene una sintaxis que ayuda a simularlo y para el código anterior es lo mismo "Rdata:seek("set");" que "Rdata = io.seek("set");" y lo mismo para todos los procedimiento provenientes de cualquier "clase" así que una vez que se inicializa una variable del tipo "io", podemos usar el nombre que le dimos seguido de dos puntos para acceder a los sub-métodos. Entonces, usando "seek" sin ningún parámetro adicional a "set", le indicamos que queremos mover el puntero al inicio del archivo (byte cero)
Cuando ya iniciamos todo, leemos los primeros 1024 bytes del archivo y al igual que en C#, vamos a buscar cualquiera de las etiquetas que se usan para indicar una imagen; es decir: "APIC" o "PIC". Algo que probablemente olvide decir en el primer post sobre imágenes en los MP3's es la importancia de buscar primero "APIC" a algunos les resultará obvio cual es la razón pero a otros no. La razón es simple si buscamos PIC (que corresponde a la versión 2), el resultado de la búsqueda sera verdadero si existe "APIC" porque esta contiene toda la cadena de caracteres que buscamos, en cambio si buscamos "APIC" primero, si no se encuentra, eso no significa que necesariamente no exista "PIC".
Para realizar la búsqueda de la etiqueta, una vez que leímos todos los bytes en los cuales podría estar, creamos un flag llamado "GotIt" del tipo "boolean" y a esta le asignamos el resultado de la función "string.find()" usando cómo parámetros "Sdata" que es una copia de "Rdata" (los 1024 bytes leídos) y es en donde buscará la cadena de texto que le pasamos en el segundo parámetro.
Repetimos lo anterior 4 veces, la primera es para buscar "APIC", la segunda para buscar "PIC" luego si la variable "GotIt" resulta "true" en cualquiera de las dos funciones, hacemos una nueva búsqueda pero ahora en lugar de las etiquetas de imagen, buscamos el tipo de imagen; ya sea PNG o JPG, pero para hacerlo, hacemos uso de de los caracteres que sirven de "encabezado" para los archivos PNG, cómo ya estamos dentro de la condición en la cual si se encontró una etiqueta de imagen, solo hacemos una comprobación y si no encontramos al "encabezado" del archivo PNG entonces la imagen es JPG
Para calcular el tamaño de las imágenes, hay que recordar que seguido de la etiqueta, los cuatro bytes siguientes para la versión tres y los tres bytes siguiente en la versión dos, indican cual es el tamaño de total de la etiqueta, para poder saber cual es el valor, bastará con multiplicar cada byte por potencias de 256, empezando de izquierda a derecha por 256^3 para la versión 3 y 256^2 para la versión dos.
Finalmente guardamos la imagen haciendo uso de un escritor de archivos que se usa igual al de C, es decir creamos el archivo e indicamos cual es el modo en el cual se trabajara, cuando usamos "wb" indicamos que abriremos un archivo pra escribir de forma binaria, si el archivo no existe, se creara uno nuevo.
Para poder usar la función, en ZeroBrane presionaremos F6 y en la parte inferior, el programa no preguntará por la ubicación de una canción seguido de la ubicación que usaremos para guardar la imagen, para este ultimo es importante solo indicar la ruta y el nombre del archivo sin extensión, dentro del programa al determinar si la imagen es jpg o png automáticamente agrega la extensión adecuada.
 |
| Si observas bien, el archivo de imagen solo tiene la ruta y el nombre, pero no la extensión. |

Y bien por ahora es todo, el código lo puedes copiar y pegar para probarlo.
Los leo luego.
El reto de Xwork #3.
Hola de nuevo a todos, el día de hoy solo vengo a dejar el reto de Xwork.

Si llevas tiempo visitando el blog no tardarás tanto en encontrar la respuesta.
Hay que recordar que el primer desafio solo fue resuelto por el usuario Zed0008 (que ya tienen su lugar en el salon de la fama). Y que el reto #2 sigue abierto.
Los leo luego.

Si llevas tiempo visitando el blog no tardarás tanto en encontrar la respuesta.
Hay que recordar que el primer desafio solo fue resuelto por el usuario Zed0008 (que ya tienen su lugar en el salon de la fama). Y que el reto #2 sigue abierto.
Los leo luego.
¡¡Feliz aniversario!!
 |
| Primer imagen representativa del blog. |
Hace exactamente dos años, un día 21 de junio, me di a la tarea de empezar con este blog. Aunque al inicio era un poco escéptico sobre que tanta aceptación podría llegar a tener, al paso del tiempo me di cuenta de la aceptación que poco a poco iba tomando lo que me motivo a continuar con los proyectos.
Durante mucho tiempo acumule software que jamas publiqué y que solo se iba perdiendo entre montañas de CD-Roms y sectores defectuosos de discos duros. Nunca me moleste en "presumir" que hice tal programa o que X programa que subi a MEGA (R.I.P) se descargo tantas veces que pude comprar una cuenta premium por un mes. Nunca pensé que todo el código fuente que escribí le resultara útil a alguien más.
 |
| Segunda imagen representativa del blog (Primer aniversario). |
Cómo cualquier cosa, en el transcurso de estos dos años han habido altas y bajas, temporadas en las que fluyen las ideas cómo si de un río se tratara, pero hay ocasiones en las que otras cosas me distraen de hacer algo que valga la pena publicar, pero me he dado cuenta que la gente se sigue dando vueltas por acá y eso ayuda mucho a seguir.
 |
| Tercera imagen representativa del blog (Segundo aniversario). |
Los leo luego. ¡¡Gracias Totales!!
Bienvenidos a la cultura de lo desechable.
 |
| La imagen fue tomada de: Revista Quaestionis |
Es bien sabido por todos que en la actualidad se usan los servicios "en la nube" para guardar información. Ahí depositamos toda nuestra vida: la fotos con nuestros amigos, nuestra música favorita, nuestras series favoritas y todo lo relacionado a nuestro teléfono.
Hace 20 años nos resultaba difícil el poder guardar una canción completa en un disquete por la simple y sencilla razón que estos solo pueden almacenar 1.44 MB o 2.88 MB en el mejor de los casos y una canción de cuatro minutos ocupa 8 MB.
Con el tiempo este tipo de problemas se resolvieron y poco a poco se empezaron a ver volúmenes de información bestiales en algo tan pequeño cómo una uña. Hoy en la actualidad es muy común ver unidades USB flash de 16 GB en promedio, tarjetas de memoria micro SD de igual capacidad y ambas por un precio ridículamente bajo o alto; eso si lo comparamos con el almacenamiento tradicional o mejor dicho del disco duro tradicional que en la actualidad pueden ser de 320 GB para el usuario promedio.
Con tantos datos cualquiera pensaría que la gente optaría por tener una copia de su canción favorita, el vídeo más visto de Internet almacenado para verlo un poco después y a la hora que sea; mas no fue asi. Junto al auge del almacenamiento masivo también se dio el auge de los dispositivos móviles, cualquier experto en el 2004 hubiese pronosticado que al ir incrementando los dispositivos móviles, a demanda de almacenamiento también lo haría... Y no fue así, solo por un tiempo se dio esa tendencia pero después Apple presento lo que seria la introducción al almacenamiento masivo en la nube y todo cambio.
El servicio de ICloud sirve para almacenar todos los archivos; <primordialmente> del dispositivo de Apple; llámese Ipod, Ipad o Iphone. El hecho de poder acceder a una foto; por ejemplo; que se tomó desde un IPhone y verla en un IPad que tiene una pantalla mucho más grande y sin hacer nada adicional, significó una revolución.
Poco a poco empezaron a proliferar los servicios que ofrecían almacenamiento en la nube y algunos fueron un poco más allá. Todas las personas que poseen un smartphone no solo lo usaran para llamar por teléfono o enviar e-mail, también lo usaran para otras cosas cómo jugar, oír música o ver videos y aquí es cuando entra el ingenio.
Cómo mencione un poco más arriba, el almacenamiento ha crecido de forma exponencial, los dispositivos multimedia tambien lo hicieron y con esto también lo hizo el contenido y a pesar que 64GB pueda parecer mucho, si lo llenamos con video de alta calidad solo podríamos almacenar de 10 a 30 horas de este. Ahora imaginemos que guardamos nuestra serie favorita en mi caso es Monk y se divide en ocho temporadas de 16 capítulos y cada uno dura 40 minutos, usando la métrica anterior tenemos que dura 64 horas y requeriría 128 GB para poder almacenarla.
Tomando en cuenta que también quiero escuchar música y quiero ver otras series, resulta imposible tenerlo todo a la mano. A alguien se le ocurrió este problema y dijo "usemos la nube" y así fue cómo empezaron a surgir servicios cómo netflix y todos los derivados para el consumo de video; y spotify para el consumo de audio. Anteriormente existían servicios que almacenaban archivos pero solo hacían eso, si querías hacer uso de un archivo mp3 tenías que descargarlo.
Poco a poco estos servicios empezaron a dominar el mercado y ahora resulta difícil de alguien que no haya utilizado en alguna de las ocasiones alguno de estos servicios. Para algunos es una ventaja y resulta en cierta parte razonable, nunca me he preguntado donde están mis discos de soda estéreo de la década de los 90's incluso es más fácil buscar la canción en spotify que buscar el disco, el lector y mis audífonos.
Pero por otro lado y a partir de aquí son solo especulaciones mías. El hecho de tener todo disponible a la mano, hace que la gente se acostumbre a eso. Algo no esta disponible, entonces no debe de ser bueno o tengo todo el mundo por ver pero no se por donde empezar. A lo mejor exagero un poco, pero las nuevas generaciones al nacer inmersos en estás cosas, se dan el lujo de hacer lo mismo con las personas, se reemplazan amigos más rápido que lo que cambian de zapatos, tienen parejas que solo duran dos o tres meses, se casan y el "amor" dura un par de años. Resultaría un tanto injusto decir que es debido a Netflix pero de algo no hay duda, vivimos en la cultura de lo desechable.
P:D: Me invitaron a escribir aquí por los dos años de este blog, no cuenten con volver a leer nada que provenga de mi. Además cualquiera daría por muerto al dueño.
Inutil apps #4 - Visualizador de sonido (pt. 2.)
Hola de nuevo a todos, el día de hoy vamos a continuar con la construcción del visualizador de sonido.

En el post anterior vimos cómo hacer las conexiones en el diagrama, hoy solo veremos cómo ensamblarlo.
Para que se más vistoso decidí hacer una caja de 100 cm x 10 cm x 10 cm con madera de 0.4 cm. para eso corte 2 pedazos de 100 cm x 10cm y once pedazos de 10 cm x 10 cm para usarlos cómo divisores.


Para unir todo simplemente use clavos de 1.27 cm y pedazo de madera de 9 cm x 2 cm x 2 cm. Odio admitirlo, pero de esta parte no gusto tanto el resultado porque se así:

Y se notan más cuando la luz se enciende pero a pesar de todo decidi mantener el diseño cómo simple recordatorio de que hay que planear bien todo desde el principio.
Luego pegue los LED's usando silicón caliente, puesto que esto esta diseñado para no moverse mucho, en lugar de usar clavos o un pegamento más potente, el silicón cumple con su trabajo a la perfección y por eso también lo use en los espaciadores.

Cuando terminé de pegar los LED's use cable "rainbow" de 8 buses (que era la que tenía a la mano) + dos cables 28 AWG para hacer las conexiones hacia el circuito controlador, hay que recordar que el integrado LM3915 /14/16 va a manejar cada LED desde su cátodo por lo que estos deben de ir por separado. Para el anodo, igual use cable 28 AWG, cada modulo LED usa 20 mA por lo que suponiendo que todos estén encendidos a su máxima capacidad, solo circularan 200mA por este cable.

Finalmente solo conecte el circuito ya hecho, todo parecía funcionar de maravilla, pero aqui vuelvo a remarcar la importancia de planear estás cosas. A pesar de que es un proyecto que llevo "haciendo" desde el 2014 (15?) cuando por pura casualidad le dije a una amiga sobre mi adicción a las luces sensibles al sonido y ella me consiguió los primero lm3915 (que todos esos murieron en nombre del progreso). Hasta ahora que en teoría ya debería de tener una idea clara de que y cómo hacerlo. Simplemente no aprendí nada ya que no tome en consideración el espacio para anclar debidamente todo el circuito y simplemente lo deje así; colgando.
Aunque es una mala practica dejar las cosas "cómo queden", por está ocasión la dejare así, ya que el resultado es igual a cómo lo imaginé hace mucho.
Los leo luego.
P.D:
 |
| Lo admito. |
Suscribirse a:
Entradas
(
Atom
)


